
こんにちは。お昼は激安スパゲッティで100円程度に食費を抑えている私です🍝
最近はオンラインミーティングの機会が増えて、tl;dvを使って議事録の要約を自動生成するようにしていましたが、無料プランを使い切り、代わりに編み出したスキームについてご紹介していきます。
背景:無料プランで詰まったところ
tl;dvはZoom / Google Meet / Microsoft Teams の会議に参加して、録画・文字起こし・AI要約までやってくれるサービスです。公式の情報だと、無料プランでも以下は制限されていません。
- 録画は無制限
- 文字起こしも無制限(30言語以上)
- 手動タイムスタンプのメモ
制限がかかっているのはAI機能とストレージ側で、AIノート(要約)が約10ミーティングまで、録画の保存は3ヶ月、しかも数日で長期アーカイブへ移動されて、動画を見るには解除操作が必要になります。


で、私はこの要約の枠を使い切りました。あっという間ですね。
ところが実際の私の環境では、要約が完全に使えなくなっています。10分ぶんも生成されません。
ドキュメント上の挙動と実際が食い違っているので、ここは「自分の環境ではこうだった」という話として読んでください。
要約が使えないなら自分で要約すればいい、という話になるのですが、そこで気づいたのがtl;dvのデスクトップクライアントは録音ファイルをローカルに残しているということです。ユーザーホーム直下の .tldv フォルダに .webm として溜まっていました。
つまり、素材はすでに手元にあるわけですね。あとはこれをどう要約に持っていくかという問題になります。
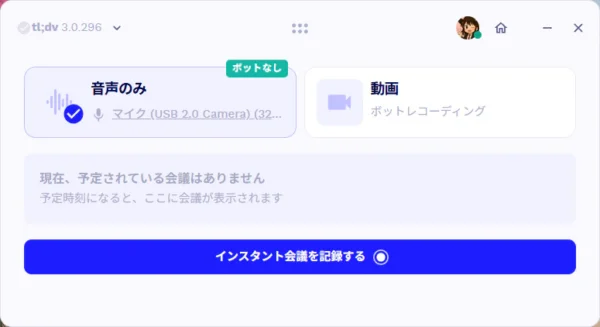
tl;dvのクライアント。カレンダーと連動したり無料プランでも割と使える。
選択肢を3つ比べた
考えた選択肢は次の3つです。
選択肢1:tl;dv Proにする
素直に課金する案です。要約が無制限になり、テンプレートや各種連携も開放されます。価格は年払いなら月あたり3,080円、月払いだと4,980円(2026年9月時点の公開価格)。
会議が週に何本もある人なら十分に元は取れると思います。ただ私の場合、要約したいミーティングは多くても月に数本で、その頻度で月3,080〜4,980円はさすがに割高でした。
選択肢2:ローカルのWhisperで文字起こしする
以前、話者分離(pyannote)込みでWhisper-WebUIをRTX 4060上に立てたことがあるので、この資産を使う案です。ローカル完結なので外部にデータが出ないのも利点です。
ただ、実際に運用しようとすると引っかかる点が2つありました。
- 処理時間がそれなりにかかる。
large-v3+話者分離込みで、約54分の音声に9分8秒でした(RTX 4060)。実時間のおよそ6分の1で、待てない長さではないものの、会議のたびにGPUを回して待つのは地味に効いてきます - 固有名詞の精度が出ない。文字起こしそのものは素の音声だけを見るので、会社名・製品名・人名といった「文脈を知らないと当てられない語」を高確率で外します
- 話者分離もそこまで強くない。きれいに分かれるときもあるが、当てにしていると崩れる
そして何より、Whisperで文字起こしをした後、その文字起こしを要約する工程が別途必要です。文字起こしは手段であって、欲しいのは議事録なんですよね。
選択肢3:録音をGemini Notebookに渡して要約させる
Gemini Notebook(旧NotebookLM)は音声ファイルをソースとして受け付けて、そのまま質問できます。文字起こしと要約が一体で済むので、工程が1つ減ります。

名前が変わっただけで製品は同じもので、作成済みのノートブックやソースはそのまま引き継がれ、移行作業も不要です。
アプリのURLも
notebook.google.com に移っていますが、旧アドレスは自動でリダイレクトされます。ネット上の解説記事はまだ旧名称のものが多いので、調べるときは両方の名前で探すと早いです。
さらに重要なのが、Gemini Notebookは複数ソースを並べて回答を作るということです。音声と一緒に「事前情報」をテキストソースとして放り込めます。ここが決め手になりました。
比較表
| tl;dv Pro | ローカルWhisper | Gemini Notebook | |
|---|---|---|---|
| 追加コスト | 月3,080〜4,980円 | 0円(GPU所有前提) | 0円 |
| 初期構築 | なし | Docker / pyannote / 依存関係でひと苦労 | MCP接続のみ |
| 所要時間 | 会議終了から10分くらい? | 54分の音声で9分8秒(large-v3 / 話者分離込み / RTX 4060) | 同じ54分の音声で約60〜90秒(変換+アップロード+処理) |
| 文字起こし→要約 | 一体 | 別工程が必要 | 一体 |
| 固有名詞の精度 | (未検証) | 低い(参考情報を渡せない) | 事前情報を渡せば補正できる |
| 話者分離 | あり | あるが精度は控えめ | 厳密な切り分けは期待しない前提で使う |
| データの置き場所 | tl;dvのクラウド | 完全ローカル | Googleのクラウド |
なぜGemini Notebookを選んだか
コストがゼロというのは前提として、決め手になったのは別のところでした。
ポイント1:Obsidianの関連情報を丸ごと渡せる
私は案件ごとのノートをObsidianのVaultで管理しています。企業ノート、過去の面談ノート、タスクノートに、会社名・サービス名・登場人物の正しい表記がすでに揃っているわけです。
この構成では、音声ファイルをアップロードした後にもう1つ「事前情報」というテキストソースを追加して、そこへVaultから集めた情報を流し込んでいます。
- 対象タスクノートの本文(議題・サブタスク・メモ)
relatedでリンクされた関連ノート(企業ノートなど)- 同じ案件の過去のミーティングノート
- 上記から抽出した固有名詞リスト(会社名・製品名・人名の正しい表記)
そして要約を依頼するときに、「文字起こし側の誤認識をこの表記で補正してください」と明示的に指示します。
素の音声しか見ていないモデルは固有名詞を当てられませんが、正解表記のリストを同じコンテキストに置いておけば復元できる。Vaultに情報を蓄積している人ほど効く構成だと思います。
ポイント2:短時間で終わる
録音ファイルをmp3に変換してアップロードし、要約できる状態になるまでの実測が以下です。
| 録音長 | 元ファイル | mp3変換 | 変換後 | アップロード | Gemini Notebook処理 | 合計 |
|---|---|---|---|---|---|---|
| 54分 | 54.4MB | 9.4秒 | 26.8MB | 9.2秒 | 40〜70秒(推定) | 約60〜90秒 |
1時間弱の会議でも、2分待たずに質問できる状態になります。同じ54分の録音をローカルのWhisperに投げると9分8秒だったので、待ち時間としては1桁違うことになりますね。
変換処理も軽く、54分・54.4MBの録音でも10秒かかりません。100分規模でも問題ないペースですね。
音声の長さと処理時間がきれいに比例しているわけではなく、混雑具合でもぶれる印象があります。オーダーとして「数十秒〜2分」と捉えるのが実態に近いです。
ポイント3:要約の裏取りに再利用できる
ノートブックを残しておけば、後から「この決定事項の根拠は?」と追加で質問できます。文字起こしテキストをファイルで持つよりも、あとから掘りやすいのが良いところです。
実装の概要
一連の流れをClaude Codeのスキルにして、/meeting-summary で回るようにしました。GitHubで公開しています。
導入はプロジェクトのスキルディレクトリにcloneするだけです。SKILL.md と references/ がセットで配置されていれば動きます。
git clone https://github.com/seizu-dev/meeting-summary-skill.git \
<project>/.claude/skills/meeting-summary
全体はこんな構成です。
flowchart TD
    s0_task["Obsidian<br/>タスクノート"] --> s0_rel["関連ノート・<br/>過去ミーティングノート"]
    s0_rel --> s0_pre["事前情報<br/>(固有名詞リスト付き)"]

    s0_rec[".tldv フォルダの<br/>録音ファイル(.webm)"] --> s0_ff["ffmpeg で mp3 化<br/>(モノラル / 16kHz)"]
    s0_ff --> s0_nb["Gemini Notebook"]
    s0_pre --> s0_nb

    s0_nb --> s0_ask["要約を質問<br/>(誤認識の補正指示つき)"]
    s0_ask --> s0_draft["ドラフトを提示<br/>(人間がレビュー)"]
    s0_draft --> s0_save["12_Meetings/ へ保存<br/>タスクノート更新"]
手順の詳細は省きますが、ハマったところだけ2点書いておきます。
1. .webm はそのままでは受け付けられない
.tldv に残るファイルは拡張子が .webm ですが、中身を確認したらMP4コンテナ+Opus音声でした。拡張子が実態と一致していないんですね。そのままアップロードするとHTTP 400で弾かれます。
ffmpeg で映像を捨ててmp3化すれば通ります。音声認識用途なのでモノラル・16kHzで十分です。
ffmpeg -y -v error -i input.webm -vn -ac 1 -ar 16000 -b:a 64k output.mp3
2. ファイル名から録音時刻を割り出す部分でタイムゾーンにやられた
ファイル名の末尾に入っているISOタイムスタンプはUTCの録音開始時刻なので、+9時間してJSTにする必要があります。ここで環境によってはtzdataが無く TZ='Asia/Tokyo' が効かない、date -d "... UTC +9 hours" は環境のローカルTZ変換と二重に加算されて+18時間ずれる、という罠を踏みました。
結局、エポック秒に直してから32400秒足す方式に落ち着きました。素直にこれが一番確実です。
残課題・注意点
固有名詞の誤認識はやはり多い
事前情報で補正する前提とはいえ、文字起こし側の誤りは相当な量です。実際に観測した例を一部だけ挙げます。
| 実際 | 文字起こし結果 |
|---|---|
| 受託開発 | 自宅開発 |
| 選考期間 | 商用期間 |
| 承認制 | 証明性 |
| 週3 | 修産 |
| Claude Code | マックロードコード |
| Gemini | ジミニ |
会話の流れや、社員数・出社日数のような数値は概ね正確に取れます。一方で固有名詞と同音異義語はまったく信用できないという切り分けになりました。
なので要約結果をそのまま保存するのではなく、必ず一度ドラフトとしてレビューを挟む運用にしています。事前情報で裏が取れない固有名詞は、断定せず確認する。ここを自動化しきらないのが安全だと思います。
話者の切り分けは期待しない
誰が何を言ったかを厳密に分けるのは、この構成では諦めています。参加者リストを事前情報に含めて文脈から推測させてはいますが、決定事項の帰属が重要な会議では自分の記憶と突き合わせる必要があります。
録音の原本はローカルにしかない
無料プランの録画は3ヶ月保存で、数日でアーカイブへ移動されます。つまり手元の .tldv フォルダが実質的な原本です。ここを消してしまうと後から要約し直せないので、要約が済むまでは触らないようにしています。
Gemini Notebook側の上限
アカウントあたりノートブック100件 / ソース50件という上限があります。ミーティングごとに使い捨てのノートブックを作る運用だと、いずれ整理が必要になりますね。
まとめ
要約したいミーティングが月に数本という頻度であれば、この構成で十分に足りました。tl;dv Proの月3,080〜4,980円を払わずに済んでいます。
そして使ってみて分かったのは、この構成の強みがコストではなくObsidianに蓄積した関連情報を要約のコンテキストに載せられることだったという点です。素の文字起こしが固有名詞を外すのは避けられませんが、正しい表記が手元のVaultにあるなら、それを一緒に渡すだけで精度が変わります。
逆に言うと、案件ごとの情報が整理されていない状態だと、この構成の旨味は薄いと思います。Whisperで回すのとあまり変わらない結果になりそうです。
話者分離の精度をどう上げるかは残課題ですね。
スキルの使い方や細かい実測値についてはリポジトリのREADMEを参照してください。
以上!
コメント